Claude Haiku 5.5 发布:价格砍到一折,最便宜的 Claude 也变聪明了
目录
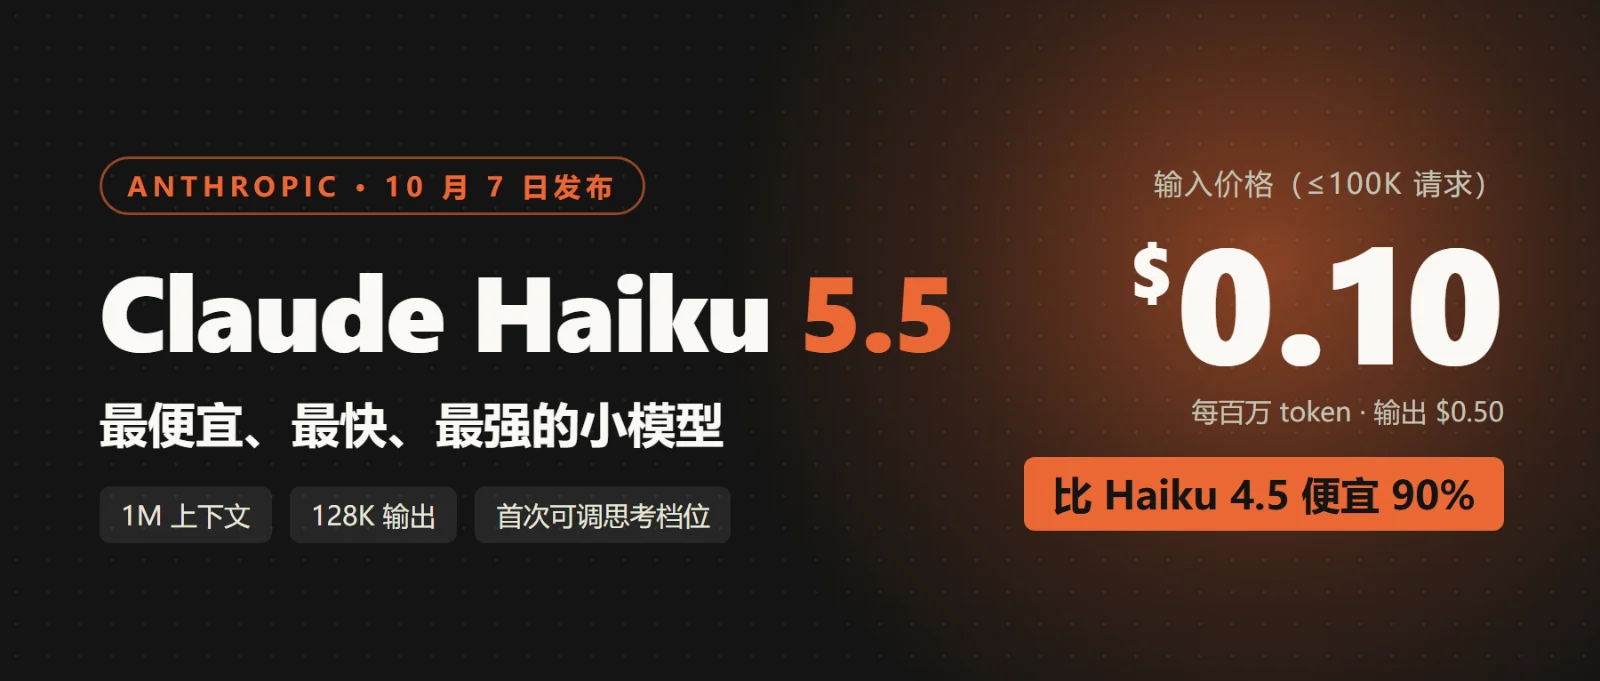
10 月 7 日(美国时间),Anthropic 正式发布了 Claude Haiku 5.5。
这是继 9 月的 Opus 5.5、Sonnet 5.5 之后,Claude 5.5 家族的第三个模型,也是最后一块拼图。距离上一代 Haiku 4.5 发布,刚好过去一年。
官方对它的定位是:“迄今为止最便宜、最快、能力最强的小模型。”
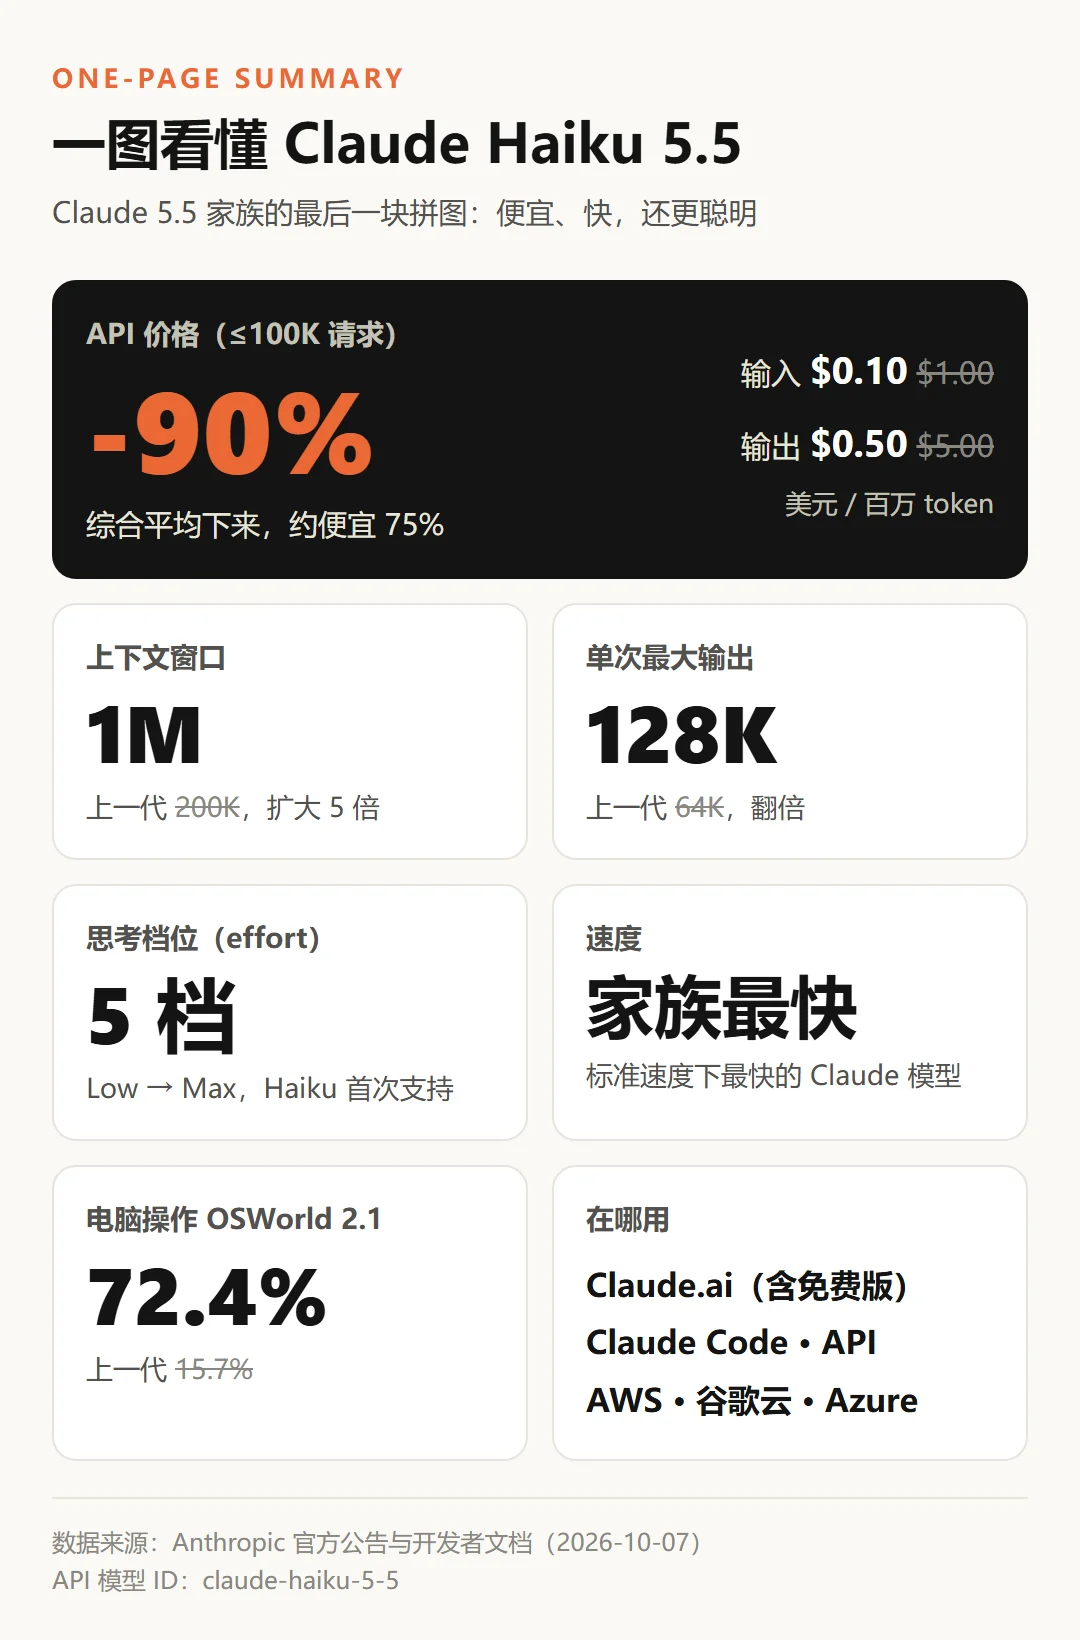
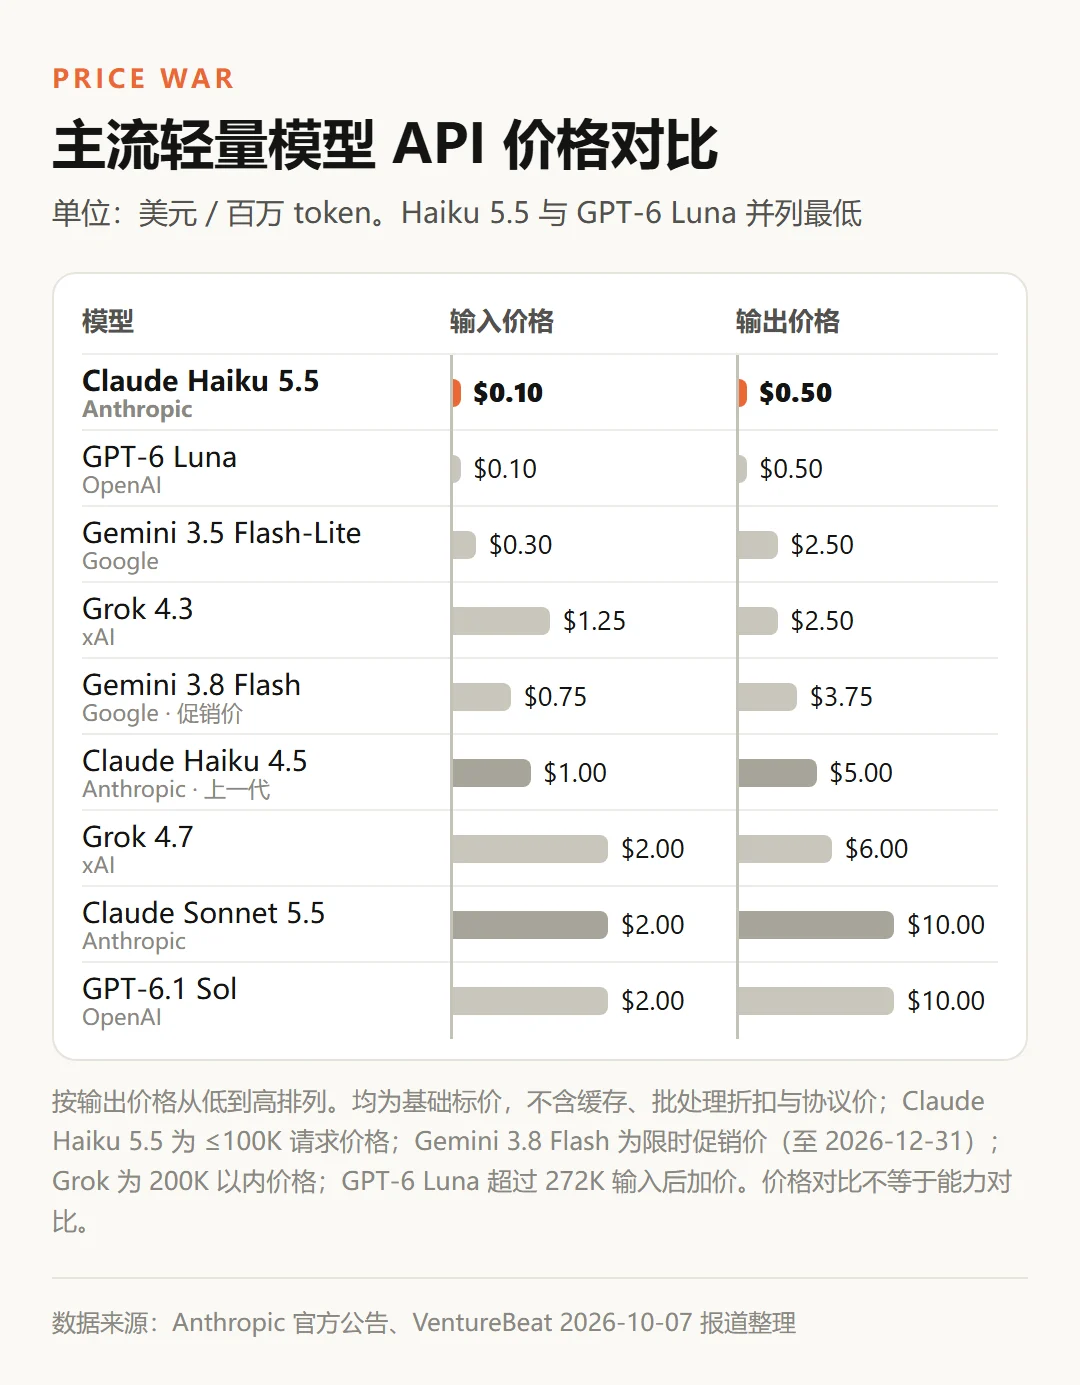
这次最大的看点不是跑分,而是价格:每百万输入 token 只要 0.1 美元,比 Haiku 4.5 便宜了 90%。
价格:直接打到一折
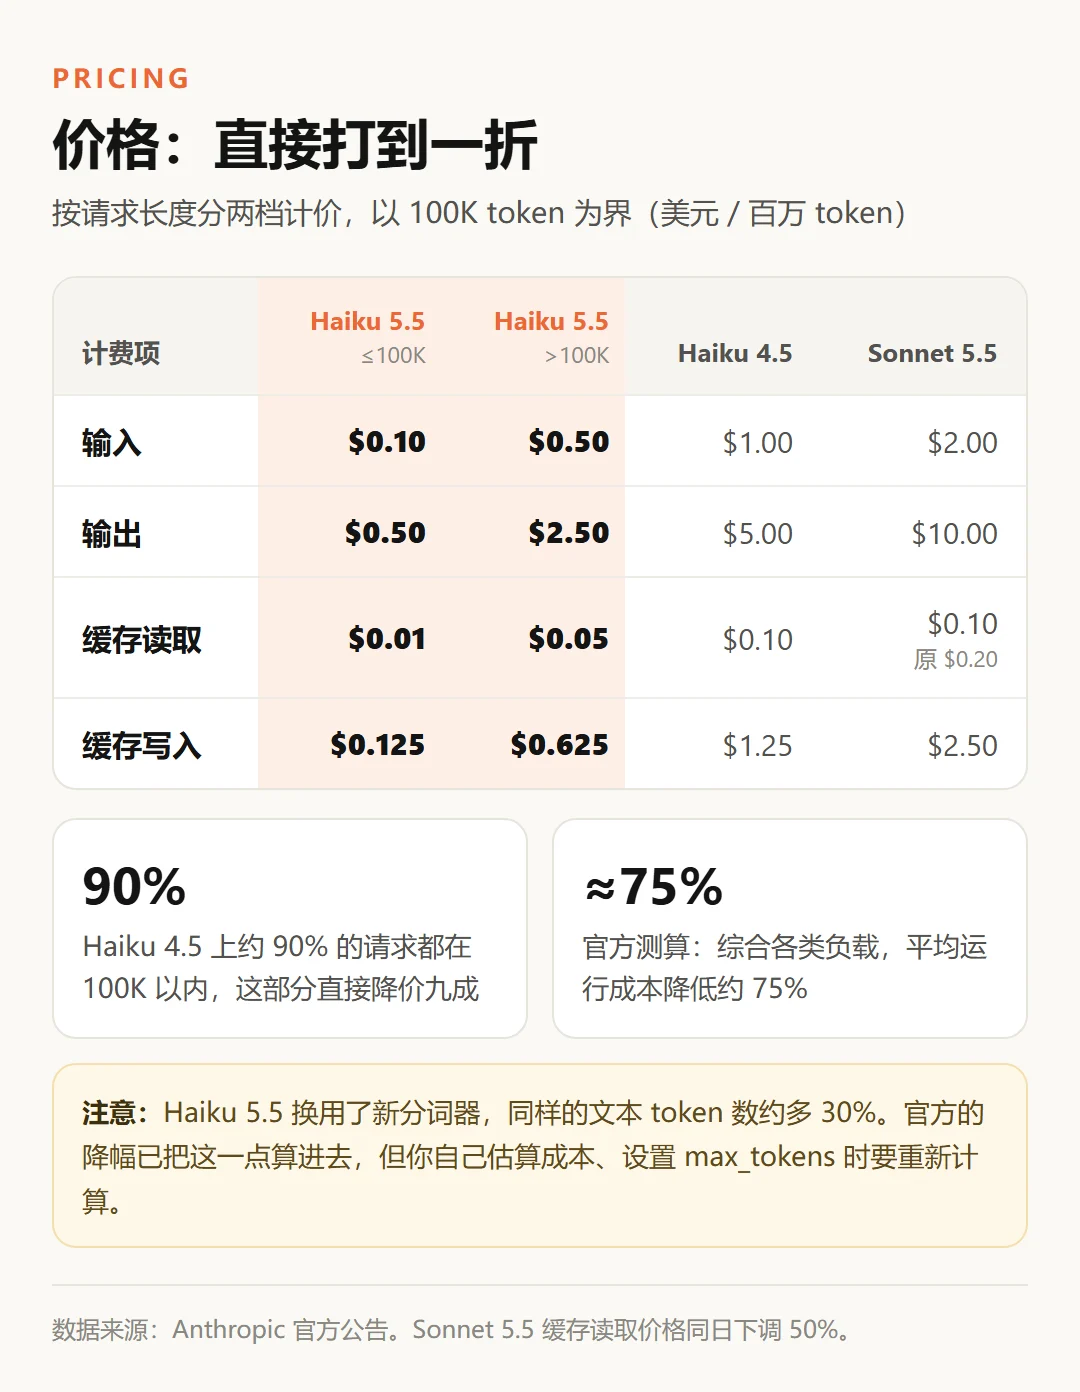
Haiku 5.5 用了分档计价,以单次请求 100K token 为界:
- 100K 以内:输入 $0.10、输出 $0.50(每百万 token),正好是 Haiku 4.5 的十分之一;
- 超过 100K:输入 $0.50、输出 $2.50,也比 Haiku 4.5 便宜一半;
- 缓存读取低到 $0.01,长期复用同一段系统提示词的应用会非常划算。
官方统计过,Haiku 4.5 上大约 90% 的请求都在 100K 以内,所以综合各种负载算下来,平均运行成本大约降低 75%。
放到整个行业看,Haiku 5.5 的定价和 OpenAI 的 GPT-6 Luna 完全一致($0.10 / $0.50),两家在轻量模型上正面对上了;谷歌的 Gemini 3.5 Flash-Lite 输出价是 $2.50,反而贵出一截。
跑分:同价位领先,逼近 Sonnet
价格砍了九成,能力却是大幅上涨。官方公布的成绩里,拿来对比的是上一代 Haiku 4.5、同价位的 GPT-6 Luna,以及高一档的 Sonnet 5.5:
- 真实知识工作(GDPval-AA):Elo 1620,Haiku 4.5 只有 735,GPT-6 Luna 1437,已经离 Sonnet 5.5 的 1840 不远;
- 操作电脑(OSWorld 2.1):从 15.7% 跳到 72.4%,涨了将近 5 倍,大幅领先 GPT-6 Luna 的 48.9%;
- 跨学科推理(Humanity's Last Exam):不用工具 45.9%,用工具 57.4%,上一代分别只有 10.2% 和 18.7%;
- 图表理解(Chartography):从 6.4% 提升到 46.4%;
- Agent 编程(Terminal-Bench 4.0):39.2%,上一代是 0%,但和 Sonnet 5.5 的 70.6% 还有明显差距。
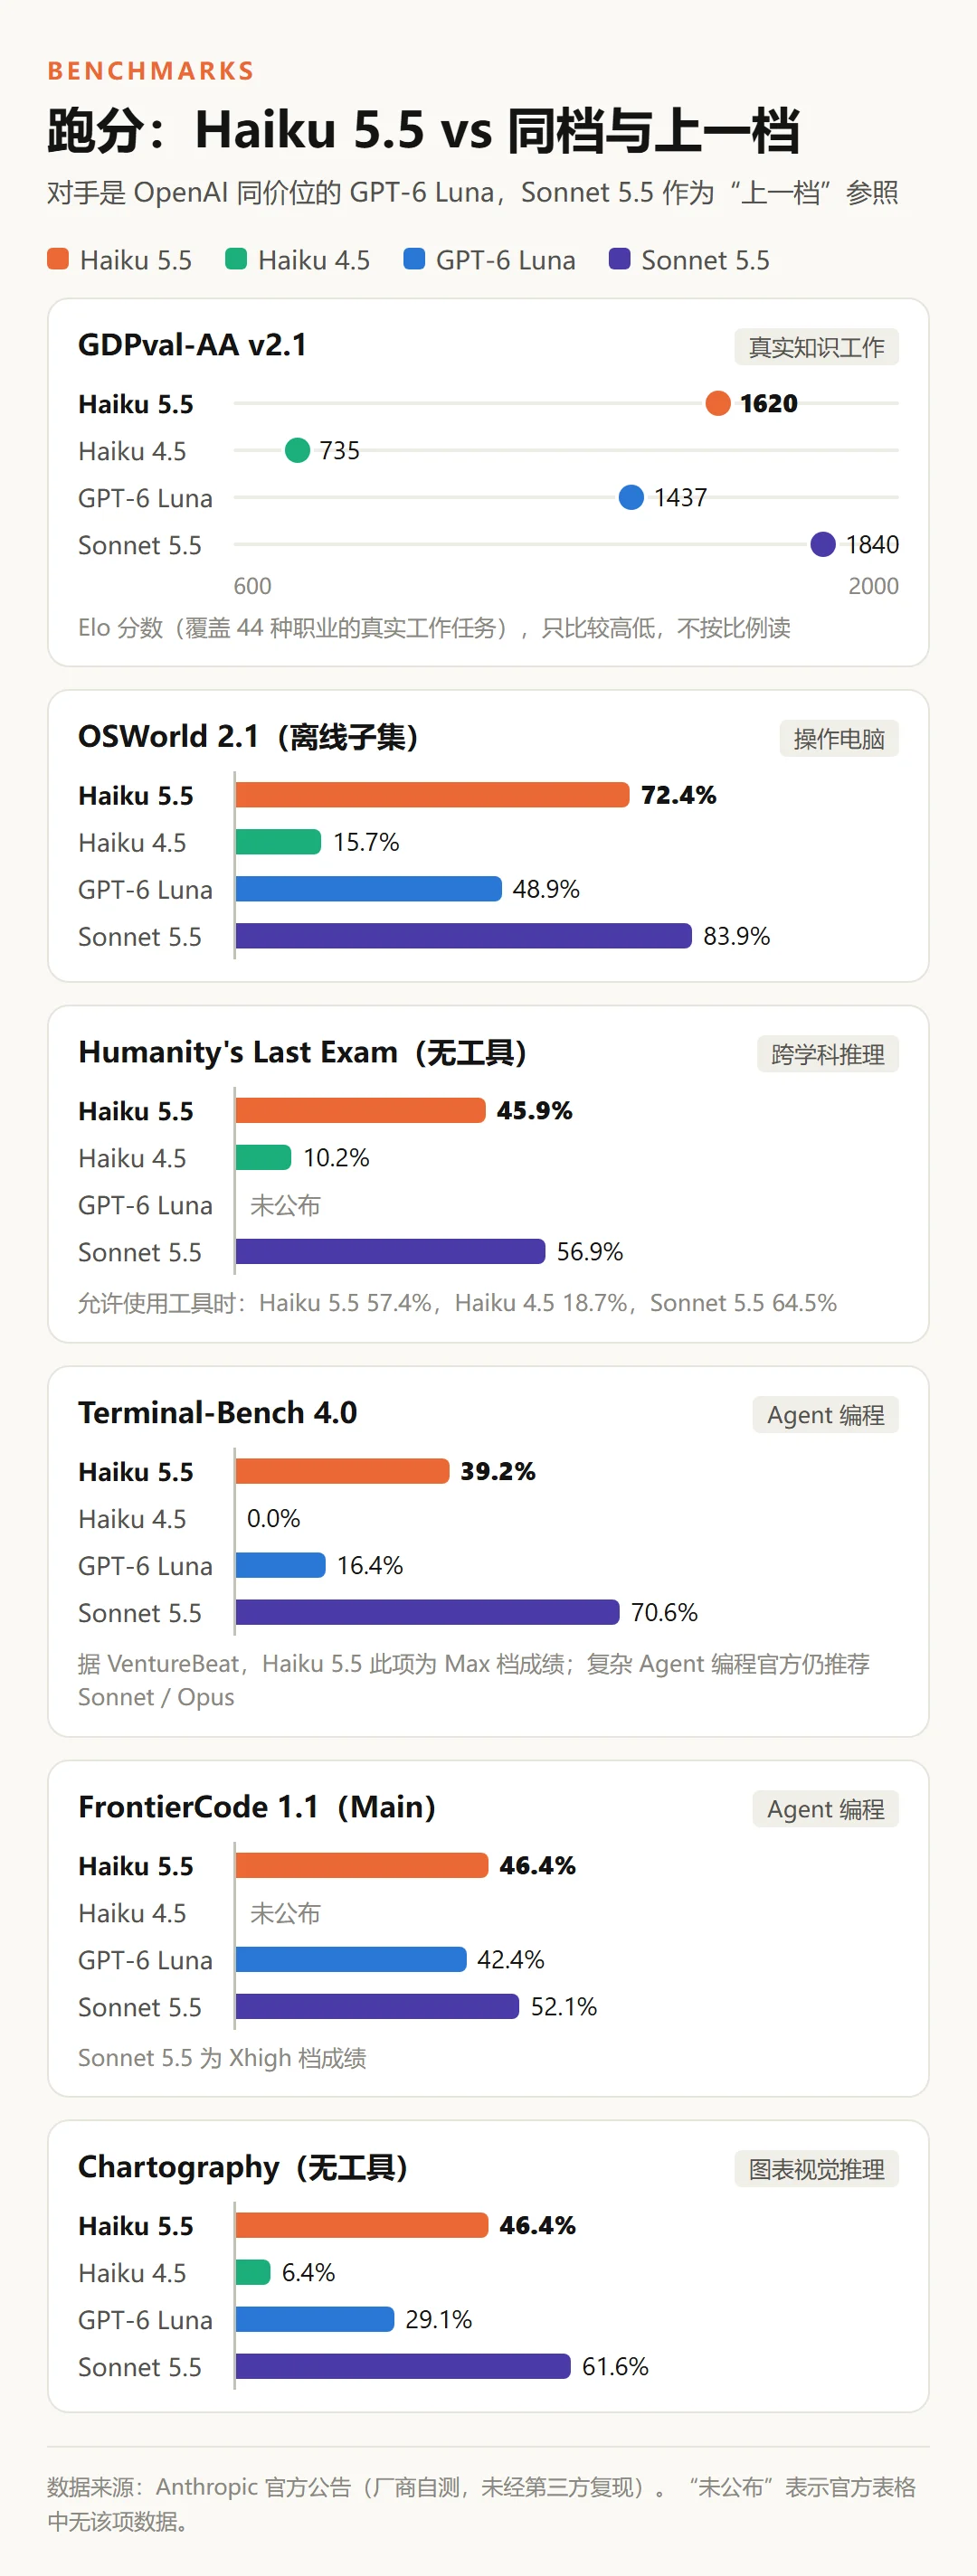
总结一下:在知识工作和电脑操作上,Haiku 5.5 已经追到离 Sonnet 5.5 不远的位置;和同价位的 GPT-6 Luna 比,所有公布的项目都领先。
不过要冷静看待:
编程能力仍然是短板。据 VentureBeat 报道,Terminal-Bench 的 39.2% 是开到最高档(Max)跑出来的,默认档位下只有 20% 左右。官方自己也说了,复杂的 Agent 编程任务,还是交给 Sonnet 5.5 和 Opus 5.5。
它最适合干什么:给大模型打下手
官方对 Haiku 5.5 的定位很清楚:不是用来替代 Opus 和 Sonnet 的,而是给它们当“子代理”(subagent)。
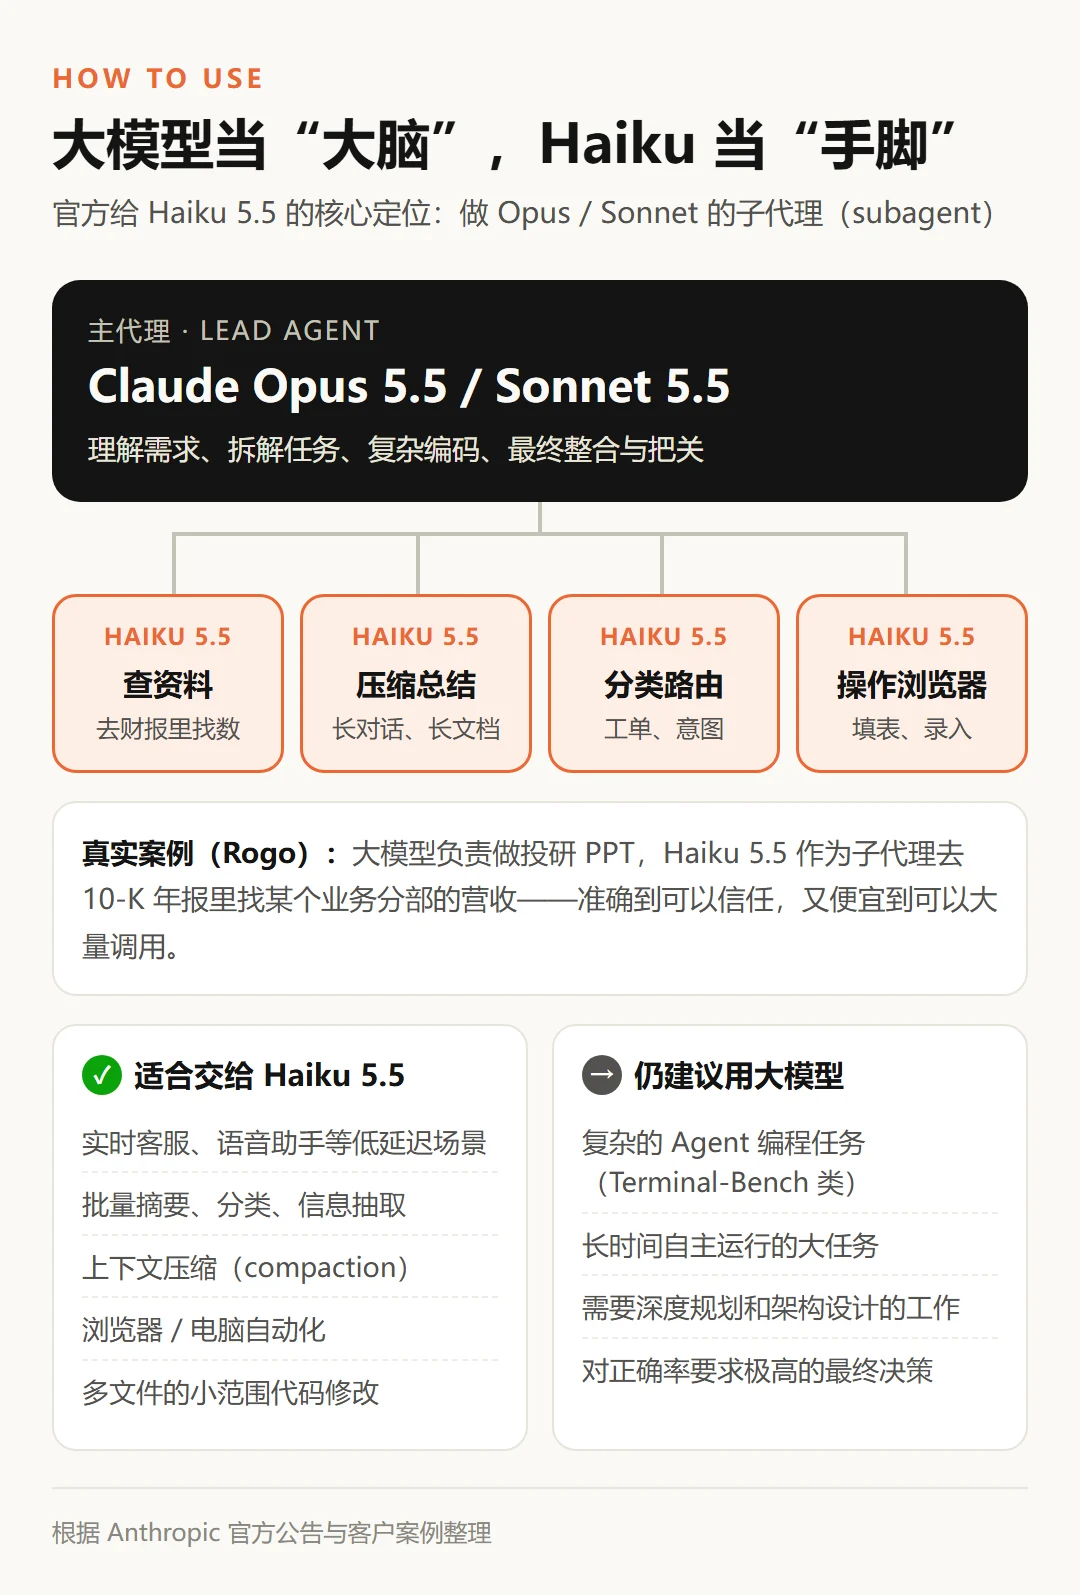
一个典型的分工是:Opus 5.5 或 Sonnet 5.5 当“大脑”,负责理解需求、拆解任务和最终把关;Haiku 5.5 当“手脚”,去做那些量大、重复、但不太需要深度思考的活,比如:
- 查资料、读文档:比如从一份财报里找出某个业务的营收;
- 总结和压缩:长对话、长文档的上下文压缩(compaction);
- 分类和路由:工单分类、意图识别、数据库查询;
- 实时交互:在线客服、语音助手这类对延迟敏感的场景,Haiku 5.5 是目前标准速度下最快的 Claude 模型;
- 操作浏览器和电脑:配合这次 Python / TypeScript SDK 新增的 computer use 和 browser use 测试版能力,做填表、录入等重复操作。
几家早期测试企业的反馈也印证了这一点:
- Asana:任务完成延迟降低 30% 以上,每轮 Agent 推理最高快了 2.5 倍;
- HubSpot:在内部 CRM 模拟任务上三轮平均得分 92.8%,是他们在这套测试上见过的最好成绩;
- AlphaSense:在一个每周约 800 万次调用的文档问答功能上,得分从 0.76 提升到 0.84;
- Box:比 Haiku 4.5 高 11 分,延迟却只有一半左右;
- Cognition:在 Devin 里用 Opus 5.5 当主力、Haiku 5.5 当“副手”,FrontierCode 跑到了 66.2 分,同时降低了成本和延迟。
如果你用 Claude Code,也可以照着这个思路来:主会话用 Opus 或 Sonnet,把自定义子代理的模型设成 Haiku,让它去跑搜索、读文件、做总结这类“体力活”,又快又省额度。
顺手更新的两件事
1. Sonnet 5.5 缓存读取价格减半
从每百万 token $0.20 降到 $0.10。官方估算,大多数 Agent 任务的成本会因此降低约 20%。
2. Max 和 Team 订阅送 API 额度
本周起,Claude Max 和 Team 订阅用户每月会获得一笔 API 额度,可以用在任意模型上:
- Max 5x:每月 $100
- Max 20x:每月 $200
- Team:最高 $500,团队成员共享
对于既用 Claude 订阅、又自己调用 API 的开发者来说,这相当于白送了一笔钱。
写在最后
Haiku 5.5 真正的意义,不在于它能不能打过 Sonnet,而在于它把一个“真正能干活”的模型,价格打到了白菜价。
进入 Agent 时代之后,token 的消耗方式已经变了:一个任务动辄要调用模型几十上百次,而其中大部分调用都是查资料、读网页、做总结这种“体力活”。以前这些活也只能交给大模型,成本高得吓人;现在可以放心交给 Haiku,大模型只负责关键决策。
“大模型当大脑,小模型当手脚”,很可能会成为接下来 Agent 应用的标准架构。
再加上 OpenAI 的 GPT-6 Luna 也是同样的价格,轻量模型的价格战已经正式打响,对开发者来说,这绝对是好事。
Sub AI · 让 AI 成为你的日常助力
看懂了,现在就用起来。
从日常写作、学习,到编程与深度研究,选一份适合你的会员,把灵感变成成果。
支持支付宝 / 微信支付 · 查看全部套餐 →